OCR
Gescannten Seiten können in durchsuchbaren Text konvertiert werden, der unsichtbar im PDF gespeichert wird, wenn es gespeichert wird. Dies ermöglicht es den Lesern des PDFs, das PDF nach dem Text zu durchsuchen und auch den konvertierten Text zu kopieren und einzufügen. pdfMachine verwendet optische Zeichenerkennung (OCR)-Technologie, um die gescannten Seiten in Text umzuwandeln. Die Umwandlung in Text durch OCR ist nicht 100% genau. pdfMachine ermöglicht es Ihnen, die Sprache auszuwählen, in der Sie OCR durchführen.
pdfMachine nutzt die Tesseract OCR-Engine, um Text genau aus gescannten Dokumenten und Bildern zu extrahieren. Tesseract ist eine leistungsstarke Open-Source-Engine zur optischen Zeichenerkennung (OCR), die von Google entwickelt wurde und für ihre Zuverlässigkeit und Unterstützung mehrerer Sprachen bekannt ist. Durch die Integration von Tesseract stellt unsere Lösung sicher, dass eine hochwertige Texterkennung ermöglicht wird, die eine effiziente Dokumentenverarbeitung und Datenextraktion ermöglicht.
OCR kann durchgeführt werden :
- Automatisch von pdfScanMachine, nachdem eine Seite gescannt wurde.
- Auf Bildern/gescannten Seiten in einem PDF von pdfMachine.
- Auf Bildern/gescannten Seiten in bestehenden PDFs von der Befehlszeile aus, ohne Benutzereingabe. Dies ermöglicht das OCR in Batches.
- Automatisch nach dem Drucken, um ein PDF zu erstellen. Nützlich für PDFs ohne durchsuchbaren Text, z.B. Bilder von Text.
- Auf zu PDF konvertierten Bildern mit dem Rechtsklick-Kontextmenü im Windows Explorer.
Um eine gescannte Seite in Text zu konvertieren, öffnen Sie diese zunächst in pdfMachine. Sie können pdfScanMachine verwenden, um eine Seite in pdfMachine zu scannen. OCR kann sogar während des Scan-Vorgangs durchgeführt werden, indem das OCR-Kontrollkästchen im Scan-Dialog aktiviert wird. Sie können jede Seite aus dem Tools-Menü in pdfMachine OCR durchführen. In beiden Viewer-Modus oder Bearbeitungsmodus wählen Sie "OCR ausführen (alle Seiten)", um OCR auf alle Seiten auszuführen.
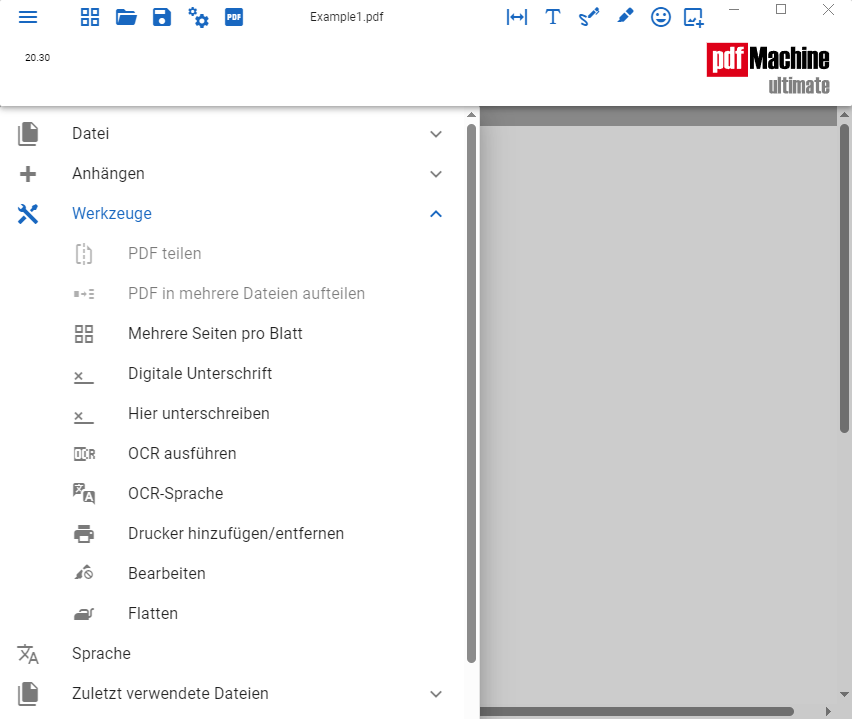
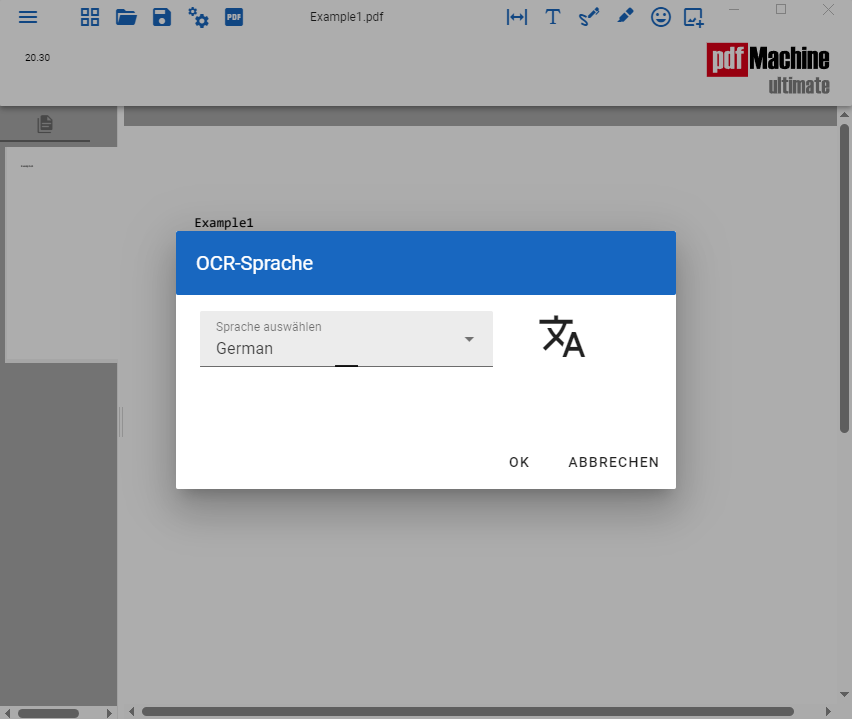
Beim allerersten Mal, wenn Sie OCR von pdfMachine ausführen, müssen Sie die Sprache der Datei auswählen, von der Sie konvertieren. Zum Beispiel, wenn Ihre gescannte Seite englischen Text enthält, wählen Sie "Englisch". pdfMachine wird dann fortfahren, die erforderlichen Sprachdateien herunterzuladen und zu installieren, um die Konvertierung durchzuführen.
Hinweis: Die Sprachauswahl wird für zukünftige Konvertierungen gespeichert. Die Sprachdateien müssen nicht jedes Mal heruntergeladen werden. Wenn Sie die Sprache ändern möchten, können Sie dies über "OCR-Sprache ändern" im Menü "Werkzeuge" tun.
pdfMachine wird dann die gescannten Seiten konvertieren.
Führen Sie ein Speichern oder Speichern unter durch, um den unsichtbaren Text mit dem PDF zu speichern.
Der Text ist nun von PDF-Readern mit Suchfunktion durchsuchbar. Der Text kann auch kopiert und eingefügt werden.
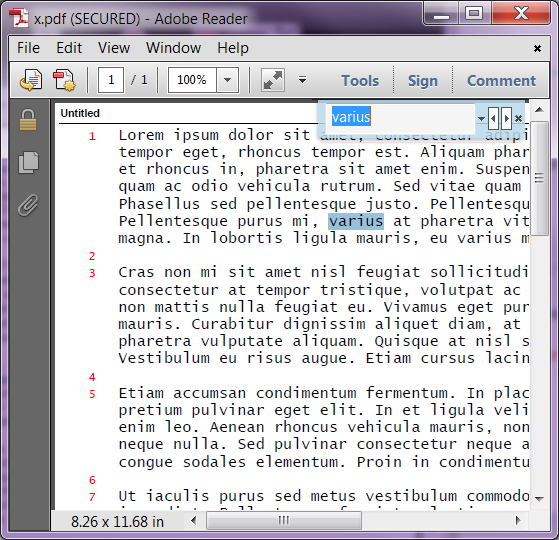
Nach OCR fügt pdfMachine unsichtbaren Text mit dem PDF ein. Der Text ist nun von PDF-Readern mit Suchfunktion durchsuchbar. Der Text kann auch kopiert und eingefügt werden.
OCR während des Scanvorgangs
Verwenden Sie pdfScanMachine um eine Seite in pdfMachine zu scannen. Aktivieren Sie das OCR-Kontrollkästchen im Scan-Dialog.
OCR beim Konvertieren eines Bildes in PDF
Beim Verwenden des pdfMachine-Rechtsklick-Kontextmenüs im Windows Explorer, um ein Bild in eine PDF-Datei zu konvertieren, können Sie das Kästchen für OCR aktivieren, um das konvertierte Bild ebenfalls mit OCR zu versehen.
OCR von der Kommandozeile
Mit dem pdfMachine-Kommandozeilen-Tool pdfMachineOCR kann OCR durchgeführt werden. Dies ermöglicht die Durchführung von OCR in Batches.
OCR nach jedem Druck, um PDF zu erstellen
Im Bereich "Nächste Aktion" der pdfMachine-Optionen können Sie pdfMachine so konfigurieren, dass OCR nach dem Drucken durchgeführt wird, um eine PDF zu erstellen, für PDFs ohne durchsuchbaren Text.
Sprachauswahl
Beim ersten Start von OCR mit pdfMachine müssen Sie die Sprache der Datei auswählen, die Sie konvertieren möchten. pdfMachine lädt und installiert die benötigten Sprachdateien für die Konvertierung. Die Sprachauswahl wird für zukünftige Konvertierungen gespeichert. Sie können diese auch über das Menü "Werkzeuge" ändern.